阿里发了100亿刀股票 字节则选择贷300亿刀

  1. 字节搞了一笔超大型银团贷款,原计划是借200亿美元,但因为银行认购过于踊跃,于是上调额度到296亿美元。

  2. 字节很喜欢搞贷款,2024年就搞过一笔,108亿美元。当时Bloomberg就认为“亚洲除日本外有史以来最大的美元计价公司贷款安排”。这次则一下子接近300亿美元。期限3+2年,与上次百亿贷款相同,还是无抵押。路透在发布这个新闻时,援引了一位参与者的说法:这种规模的无抵押贷款非常罕见,银行基本是在押注“ByteDance这个名字本身”。[1]

  3. 借这么一大笔钱当然是为了要进行ai开支,这样百亿刀规模的搞钱最近阿里也干过。不过阿里是采用增发股票的形式,额度为800亿港币——也就是102亿美元。绝对数字只有字节的1/3。

  4. 借钱肯定是要还的,发股票是不用还的。所以问题来了:字节为啥不发股票。看上去字节非常珍惜自己的股票。甚至可以说,它似乎认为自己的估值太低了,股价太便宜,搞增发不划算。

  5. 盘一下字节的估值(毕竟没上市)。最硬的一个估值来自于25年一次员工回购,按照回购价推算字节当时的估值至少是3300亿美元。因为是出钱买回自己的股票,所以这个估值属于最下限。到了25年11月,有一次外部交易,对应估值4800亿。26年General Atlantic准备出售持股时按5500亿美元估值寻价——这个水平,已经超越了腾讯阿里,成为BAT之首,与最近疯涨的长鑫持平,同为中国价值最高的两家科技公司。

  6. 路透说,字节25年全年利润大约可以达到480亿美元[2]。如果按照5500亿美元,那么就是11.5倍的市盈率。但由于目前没有General Atlantic那笔交易已经完成的消息,所以可以用4800亿美元那轮估值,那市盈率就只有10倍。如果用那个最硬(也是最保守)的回购估值,那就只有6.9倍了。

  7. 字节究竟值多少钱,这个因素也必须考虑进去:因为字节没有上市,所以股票的流动性比上市的at差——也就是说,你买入字节的股票后要抛售是相对有难度的。所以它的估值理论上就会比已经上市的at低。

  8. AI的资本开支都不是小数,动辄百亿美元规模常见得很,且都是长期性质的重资产投资(这是和以前互联网行业非常不同的地方)。阿里搞百亿美元增发而不是借款,显然保卫资产负债表的需求超过了保卫股权稀释3.57%的价值。或者这么说,阿里管理层认为当前股价已经高到足以接受3.6%左右的永久稀释,换取100亿美元永久资本。但字节显然不这么认为。字节最初计划的200亿美元融资改成增发的话,原股东会被永久稀释约4%。再结合那个480亿的利润水平,——它觉得不划算。

  9. 如果我们相信路透那个480亿利润——我倾向于认为是个运营利润,那么296亿美元贷款,相当于0.62倍的一年运营利润,所以数字虽然看着大,但并非一个特别激进的负债规模,银行争相认购就变得没啥好大惊小怪的。字节与o社a社都不大一样的地方是,它自己的现金机器相当强。它正在用成熟业务产生的信用,给新产业加杠杆。

  10. 所以,字节是用自己强大的信用,贷了一笔数额不小的款。手法上,看上去比阿里激进(毕竟是借钱),数字也是阿里的三倍。在ai领域,我一直觉得,字节依然信奉“大力出奇迹”,激进两个字嘛,文绉绉的说法叫“风险偏好高”。

  11. 字节和阿里,都不愿意靠自己的利润积累进行ai支出(腾讯目前没有大规模的ai专项融资)。阿里发了100亿美元股票,还想保卫一下资产负债表。字节索性两次背债加杠杆,加一块儿超了400亿美元。资本结构的风险偏好看,字节是最高的。

  12. 从CapEX看,ba两家旗鼓相当。25年2月,阿里宣布未来三年要干到3800亿(这是阿里过去十年AI+云投入总和以上)。到26年5月,吴泳铭说不够,准备超支。6月数字显示,已经花了一半。南华早报则说,字节2026年原计划AI资本开支约1600亿元,后来直接提高至少25%。路透则说超过1500亿。字节回应说数字不准确,但没给出它的数字。既然贷了那么多款,一年干1000亿,怕还是有的。

  13. 又大把花钱,又大把借钱,又不愿意稀释自己的股份,还有所谓承认ai支出对利润有影响,只能说是金融侧确实风险偏好高。

  14. 算力方面,字节相当彪悍。路透25年有一个报道,考虑到某些原因,就不展开细节了。总体而言,又是租(对方是微软),又是买——不是盯着一个供应商,而是多家采购。不押GPU品牌,而是要算力总量。徐锦江我全都要的即视感。[3]

  15. 据说字节也在搞自己的芯片。

  16. 业务侧,饱和式攻击,搞了一堆ai产品。今年有些变化,把很多产品集中到豆包的功能上,有一种想“包打天下”的感觉。连新发布的“豆包工作”都集成到豆包里。考虑到豆包是中国装机量和活跃用户量最大的原生ai产品,我有如下一句话判断:一旦出现PMF迹象,就立刻将抖音时代的增长机器搬迁过来。

  17. 字节25年成立Seed Edge,官方这么定位:long term、uncertain、bold的AI研究。还承诺给专门计算资源。换而言之,字节允许有一帮人短期不考虑商业KPI,烧算力做成功率未知的研究。

  18. 中国模型开源成风,已经有中开源为主美闭源为主的一种印象。但字节是一个异类。它主力模型是闭源的。开源有生态扩散优势,但字节表示,我无所谓。因为我有资本(大把利润和大把借钱)、产品(饱和式攻击和最大用户群)和流量(一堆高流量且完全用得上ai进行飞轮的app)。

  19. 字节是BAT三家中绝对意义上最咄咄逼人的进攻者,阿里则在相对意义上(毕竟阿里其实现在市值不到3000亿美元,站在它自己角度,已经相当激进了)。腾讯今年开始追赶。
—— 首发 扯氮集 ——

[1] 既然是贷款,就肯定有利率。根据报道,是SOFR+68个基点(0.68%)。总体测算下来,大概年化4.31%的水平。字节一开始想借200亿,所以它的计划是年支付利息8.6亿,占全年运营利润数字的区区1.8%,从资本配置角度,几乎约等于不值一提。另外,68bp这个信用利差极低。

[2] 这个事值得在注解里展开一下:按照国内媒体报道(财新和一财我都见过),说字节25年利润因为AI开支下滑70%,但财新没有提明确数字。一财则报道说,如果结合字节24年330亿利润(这个数字来自The Information),那25年字节利润就只有90亿美元。后来字节的公关负责人李亮对此报道有回应:相关报道中关于字节净利润下降70%,是国际会计准则的数字,但他否认了字节实际经营能力下降70%。这里存在不同的会计口径。Bloomberg后来报道说,字节前三季的net income是400亿,全年500亿。路透后来继续跟进说全年480亿(但用的是profit不是net income)。我就姑且认为是不同的会计口径,并倾向于相信Bloomberg和路透说的,是运营利润。

[3] 有兴趣可以去搜来看看,标题为《ByteDance plans $20 billion capex in 2025, mostly on AI, sources say》,我不保证该报道完全真实,仅供参考。
用豆包搭一个写稿工作流

一

作为AI原生APP,豆包在中国的用户量没有疑问地占据第一。有第三方调研机构说,到6月,其月活量达到3.82亿,比老二老三加起来的总和还要多。日活则是在春节一波推广后越过了两亿门槛。确实算遥遥领先。
我年过八旬的老父亲老母亲,都是豆包的日活用户。是,他们天天用豆包。
豆包最一开始就是个聊天机器人(bot)—— 你问它答,和市面上所有AI对话产品没有本质区别。但字节后来不断地往bot里堆功能。除了日常聊天(2c)以外,它也在努力成为一款能够接受任务、调用工具并交付结果的生产力产品(2b)。
时至今日,它能做ppt和execl,能操作本地电脑的文件和文件夹,能调用浏览器完成网页操作,能设置定时任务自动跑,能手机远程接管电脑,能完成语音通话和同声传译,能生产视频生产音乐,功能清单已经长到很难再用一个词概括它是干什么的:bot这个概念,显然不够用。
产品边界正在快速模糊,它到底是一个AI助手?一个办公套件?还是一个轻量级的操作入口?
大厂之间路线不同的产业分析先放放,本文只是探讨这样一个事:我怎么用豆包。作为一个豆包付费会员,由于它已经接入了一整套豆包工作的功能,所以得以更深入的体验。
这次我的角色不再是一个大学里的人民教师,而是一个科技行业的写作者——以评论分析为主。

二

摆在一个科技行业评论分析者面前的第一个问题是:新闻线索是什么,也就是我该就哪件事发表一次评论。早年我作为纸媒专栏作者的时候,每天都会去看一眼三大门户的科技频道所有文章的标题(说是看一眼,其实巨花时间),找一个可以写作的话题。
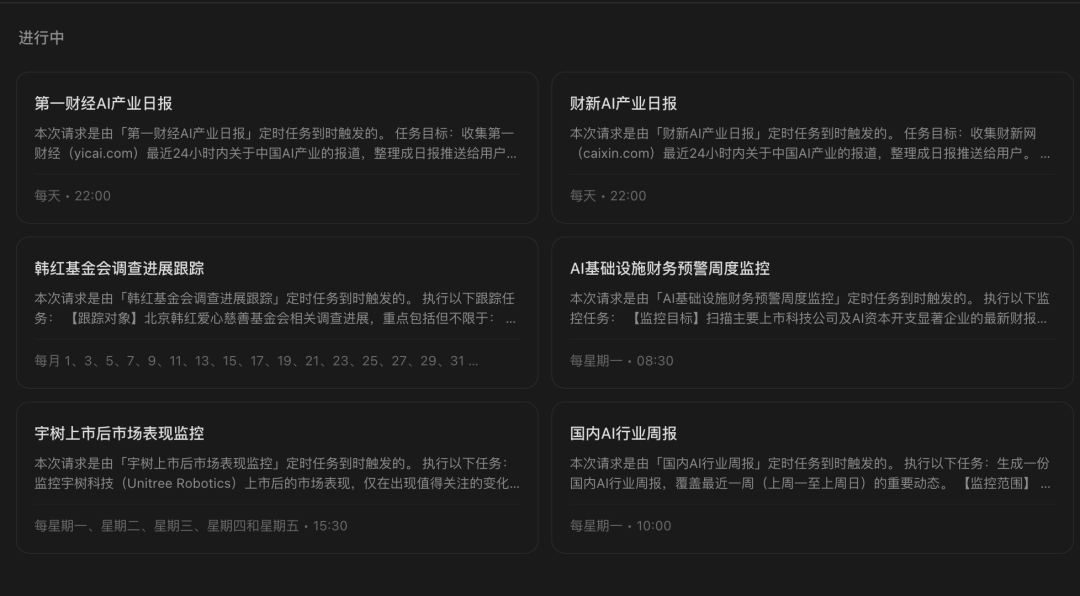
当然,到了今天,你不大可能去跑几个网站上做“看一眼今天科技新闻都有啥”的事了,海量爆炸,没人应付得过来。但我依然可以用几个定时任务器来做一些信息提醒。豆包的新版本终于加入了这个机制,我第一时间做了一些定时任务器:
在上面几个任务追踪器里,第一类是我比较信得过的媒体日报,但只和AI产业有关。无论是财新还是一财,它们不少报道其实和AI产业没什么关系,我就不浪费时间了。
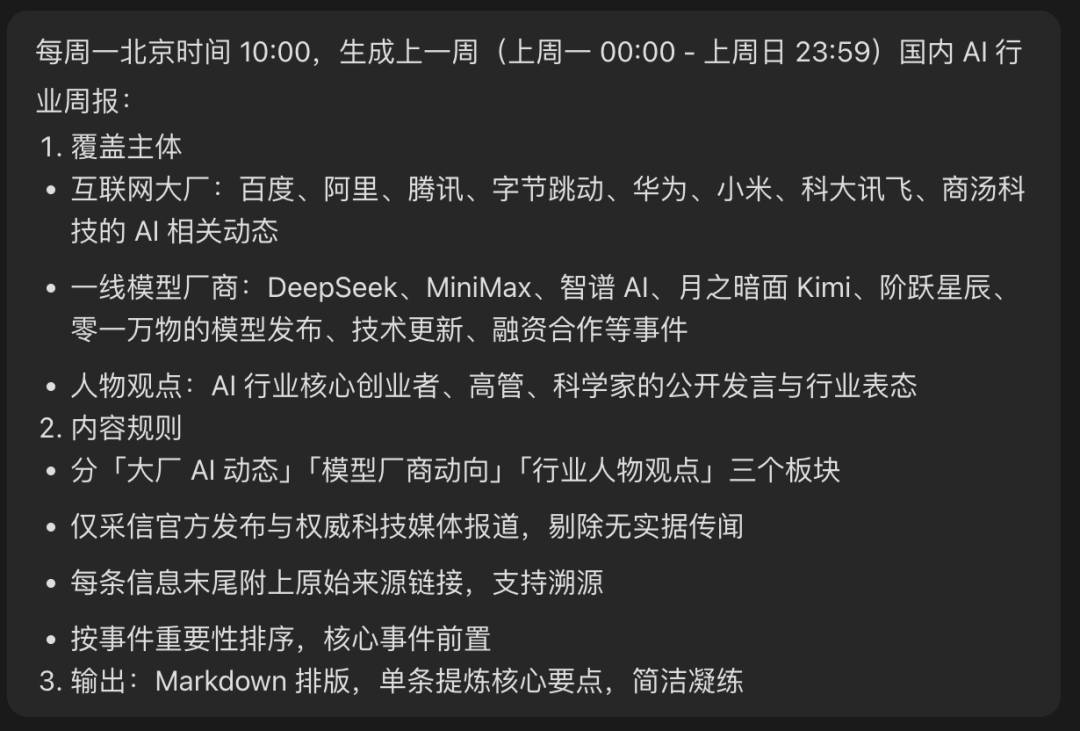
我另外做了一个AI行业的周报,这个周报的我人肉输入的提示词是这样的:

我想创建一个国内ai大厂周报,也就是国内这些搞ai的公司,包括bat这种巨头,也包括deepseek minmax这种一线模型公司。它们的动向。另外还有行业重点人物的表态发言。每周一十点给我,做一个上周的review。这些信息要有链接附注供我溯源。

豆包改成了如下指令:
这个指令其实是可以再编辑的,但我懒得编了,就先这样,过几天视情况要不要进行增减编辑——说实话,我觉得豆包确实还没搞清bat到底是哪三家:) 和token概率有关吧。
AI基础设施的财务预警周度监控,是一个很金融的任务追踪器,它涉及到的不仅是媒体报道,还有各家公司发的财报数据。我要求追踪的变量不一定科学,先跑几天看看,就不展开了。
然后我比较关心韩红基金会最近的争议,就做了一个任务追踪器,今天就触发了一个新情况给我——类似的社会事件都可以这么做,相当于用AI吃瓜。
接下来来聊聊宇树这个公司我是怎么盯着它的二级市场表现的。

三

其实作为一个科技评论者,其实与其盯着一个新闻,不如盯着一个事件的变化。
宇树上市首日大涨,股价表现出一个惊人的数字,但我认为贵得离谱。它的市盈率在首日到了六七百倍,市销率两百多倍,但它的流通盘极小,三千万股而已。首日的市场表现,用“疯狂”二字形容一点不过分。这不是一个理性的资本态度,第一天不能说明什么。
这里面存在一种可能性:Proxy Unwind。这是一个投资行业黑话(其实连金融术语都算不上),大致意思就是:当真正的核心标的终于上市落地,资金不再需要炒作 “替代概念股”,大规模把之前押注主题的代理替身仓位集体平仓抛售,引发板块集体杀估值的现象。
宇树首日的夸张表现,搭配的则是机器人板块普跌现象,所以存在Proxy Unwind的可能性。
我设置了关于大盘指数、板块表现和宇树单个股票的股价结合起来的追踪器,准备连续跟踪,来判断这三种可能性哪个更强:1)全板块风险偏好下降;2)宇树上市导致Proxy Unwind,资金从影子股/泛概念股向宇树和核心供应链集中;3)机器人主题整体估值见顶。特别关注大盘企稳后是否出现“宇树强、核心供应链强、泛概念股持续弱”的结构。如果出现足以支持或推翻上述判断的显著新证据,通知我并给出简洁结论、关键数据和来源——以上,就是我的大致提示词。
到目前为止,可以这么说,Proxy Unwind应该是被排除了,第三项的可能性在飞速上升,不过依然需要跟踪观察。
还没到可以写所谓人形机器人赛道的时候。

四

任务追踪器是写作评论的重要帮手,它实际上并不是看新闻,而是盯变化。看新闻是一个静态的动作,盯变化才是动态的。
真正有价值的线索往往不在热搜上,而在持续关注的几个特定对象身上:一家公司的股价异动、一个产品的版本更新、一位高管的公开表态、一份监管文件的措辞变化。这些东西不会每天都上头条,但它们是判断行业走向的基础数据源。
问题是,手动盯这些东西的成本极高。我不大可能每天打开n个信源,逐家去查有没有新动态。设几个日程提醒、加几个邮件组订阅是不够的,因为它只负责“通知你该去看了”,看不看、怎么看、看完怎么整理,仍然是我的事。
我所需要的新闻线索的获取,应该要从“人工巡检”变成“自动化监控”。只需要告诉它关心什么、以什么频率关注、输出什么格式,剩下的事它自己跑。对一个写作者来说,这意味着不再需要再把注意力消耗在“有没有新消息”这件事上 ,而改为需要在有新消息的时候做出判断。

五

素材有了,线索也盯到了,接下来可能会出现的问题是:不知道从哪下笔。
还是以宇树科技为例,虽然我预先想到了三个观察分析的点,但Proxy Unwind已经排除,如果另外两个点经过一段时间跟踪后,依然不成立,我该从何角度切入分析宇树?
我过去的经历告诉我,和一些行内人士聊天会激发灵感。找人聊天,大致上会有这三类好处:捋顺既有思路,找到新的观察点,以及获得过去没有纳入视野的未知的信息增量。
但找人聊天这件事,其实门槛很高。很多时候,属于可遇不可求。这年头大家都卷,不是时时刻刻就可以找到人有事没事和你扯两三个小时的。
AI就属于随时待命的,不能说它全知全能,但说它具有一定质量,是一个聊天的对象,大差不差。和AI聊天的目的是这样一句话:一个能接住模糊感觉、然后通过追问将之逼成清晰判断的。。。人?
比如用工作任务模式和豆包聊天。没有必要指令式地“给我十个角度”,而应该从这样表述开始:“我觉得宇树这事不能只写股价涨跌,但我说不清更本质的东西是什么。”
然后它会追问:你觉得不能只写股价,是因为你认为价格波动背后反映的是行业估值体系的问题,还是因为你觉得市场对人形机器人的商业化预期存在系统性偏差,还是因为你注意到了某个被忽略的细节?
多来回几轮,那个最初模糊的直觉会逐渐收敛。它可能不是直接给你一个答案,而是在追问的过程中,自己意识到 “对,我想说的其实是这个”。破题不是它递给你的,是它帮着从自己的模糊判断里逼出来的。
事实上,这种让AI逼问自己,逼出一个破题,其实是可以做成一个skill的:让AI问,而不是我问。
如果轮次足够多,看上去信息繁杂,那么开写之前,也可以考虑让豆包就此写作任务,根据上下文,列一个提纲。这样写起来会更顺遂。

六

最后还有一步:成稿后交付豆包做两件事:事实核查(尤其不要搞错数字)和逻辑推演漏洞寻找(不要出现逻辑谬误或过于跳跃)。
如果愿意,倒也是可以让它想五个标题候选的。
当一个聊天机器人开始帮着盯信息流、逼问自己的角度、核查事实和逻辑的时候,它到底还是不是bot,就让ai业界的人去争论好了,对使用者,压根不重要。
重要的是,不要把它当成一台写稿机器,而应该视为一个从起手找材料到最后出稿这一系列环节的工作流。
—— 首发 扯氮集 ——